Lemme 4
Local AI Study Assistant
Un outil d'étude qui transforme des PDF de cours en résumés, fiches, quiz et réponses appuyées sur leurs sources, grâce à un modèle de langage qui s'exécute entièrement sur l'ordinateur de l'étudiant.
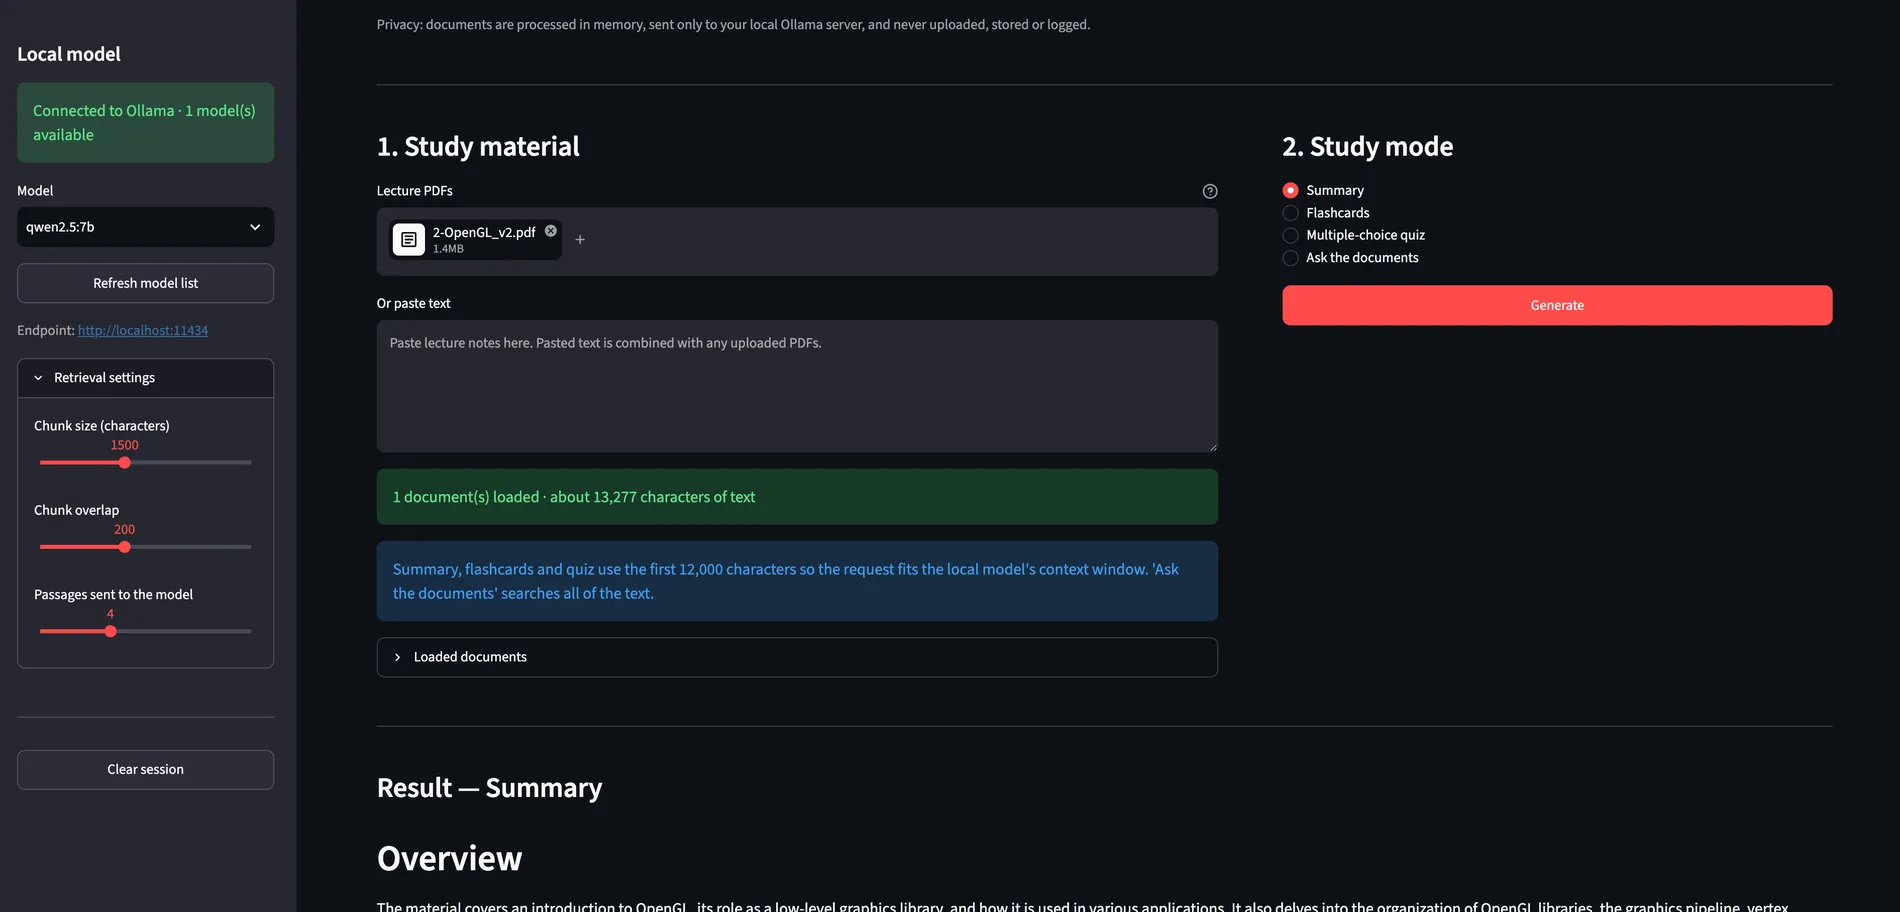
Aperçu
L'assistant reçoit des PDF de cours ou des notes collées et produit quatre choses : un résumé structuré, des fiches de révision, un quiz à choix multiples et des réponses aux questions sur la matière, accompagnées des passages dont elles sont tirées. Le modèle de langage est servi par Ollama sur la même machine : aucun document n'en sort. Il n'y a ni clé d'API, ni service infonuagique, ni base de données, ni suivi.
J'ai écrit moi-même la chaîne de recherche documentaire plutôt que d'employer un cadriciel — extraction, nettoyage, découpage, classement — afin de pouvoir expliquer et tester chaque étape.
Problème
Les outils qu'utilisent les étudiants pour réviser à partir de notes de cours exigent généralement de téléverser ces notes sur le serveur d'un tiers. Pour du matériel de cours, c'est souvent interdit, et ce n'est pas gratuit à grande échelle.
Un modèle assez petit pour tourner sur un portable amène ses propres difficultés : un chapitre entier ne tient pas dans sa fenêtre de contexte, et ses sorties structurées sont peu fiables.
Objectifs
- Garder chaque document sur la machine de l'utilisateur : traiter en mémoire, ne rien écrire sur le disque, ne contacter que le serveur local du modèle.
- Ne répondre aux questions qu'à partir du matériel fourni, et montrer les passages d'où provient une réponse.
- Ne jamais afficher un résultat défectueux : valider ce que le modèle renvoie et se rabattre sur quelque chose de lisible.
- Rendre toute la chaîne testable sans l'interface et sans modèle en cours d'exécution.
Technologies
| Application | Python 3.11+, Streamlit, Ollama (local HTTP API), requests, pypdf, scikit-learn |
|---|---|
| Tests et intégration continue | pytest, ruff, GitHub Actions, Make |
Architecture
Le fichier Streamlit ne s'occupe que de la présentation. La logique réside dans un paquet de petits modules — chargement des documents, traitement du texte, recherche, invites, client Ollama et analyse des réponses — coordonnés par une couche de service.
Pour répondre aux questions, les documents sont découpés en segments chevauchants d'environ 1 500 caractères qui se terminent, dans la mesure du possible, à une fin de paragraphe ou de phrase. Une matrice TF-IDF est construite sur ces segments, la question est comparée à chacun par similarité cosinus, et seuls les meilleurs sont transmis au modèle avec la consigne de ne répondre qu'à partir d'eux. Si rien ne correspond, la réponse « introuvable » est renvoyée sans même appeler le modèle.
Présentation
- app.pyInterface Streamlit
Ingestion
- document_loaderPDF et texte collé, en mémoire
- text_processingNettoyage et découpage
Orchestration
- study_service
- retrievalTF-IDF, similarité cosinus
- prompts
Modèle
- ollama_clientHTTP vers localhost
- response_parserExtraction et validation du JSON
Mes responsabilités
Il s'agit d'un projet individuel. Je l'ai conçu, écrit et testé.
- La chaîne d'ingestion et de recherche : extraction de PDF en mémoire, nettoyage du texte, découpage chevauchant et classement TF-IDF.
- Le client HTTP pour Ollama, doté d'une hiérarchie d'exceptions qui transforme chaque échec en message lisible.
- La construction des invites et l'analyse défensive des sorties JSON du modèle.
- L'interface Streamlit, la suite de tests et le workflow d'intégration continue.
Tous les commits du dépôt sont les miens.
Décisions d'ingénierie
TF-IDF plutôt que des plongements
TF-IDF ne demande ni téléchargement de modèle, ni base de données vectorielle, ni dépense, et ses scores peuvent être examinés et débogués. Ce qu'on y perd : la correspondance sémantique. La méthode compare des mots et non du sens; une question formulée dans un autre vocabulaire que la source donne donc de moins bons résultats. L'interface et la documentation le disent.
Pas de cadriciel pour une chaîne en quatre étapes
Découper, vectoriser, classer, ancrer : quatre étapes. Les écrire directement garde la liste des dépendances courte et me permet de rendre compte de chacune. Le prix : quelques utilitaires pratiques que j'aurais autrement eus gratuitement.
Une session HTTP injectée
Le client Ollama reçoit sa requests.Session par le constructeur. Les tests y injectent un faux objet qui renvoie des réponses préparées ou lève précisément l'exception à l'essai : rien n'est remplacé à chaud et aucun faux serveur ne tourne. La couche de service reçoit un client de la même façon, ce qui permet à un test de vérifier l'invite qui aurait été envoyée.
Valider le JSON du modèle, puis se rabattre
Les modèles locaux enveloppent souvent le JSON dans des balises Markdown ou le font précéder d'une phrase. L'analyseur retire les balises, découpe du premier crochet au dernier, puis vérifie la structure : une question de quiz doit comporter exactement quatre choix non vides et une bonne réponse qui correspond à l'un d'eux. En cas d'échec, l'utilisateur voit l'erreur et la réponse brute, et non un quiz défectueux.
Les documents téléversés sont des entrées non fiables
Un PDF peut contenir du texte qui ressemble à une consigne. Le texte des documents est encadré de délimiteurs explicites, et le message système déclare que tout ce qui s'y trouve est du matériel de référence, jamais des instructions. Cela réduit le risque sans l'éliminer, et la documentation ne prétend pas le contraire.
Tests et qualité
Six modules de test totalisant 71 fonctions de test. Chaque appel HTTP est remplacé par un faux objet injecté : la suite n'a besoin ni d'Ollama, ni du réseau, ni de PDF externe, et elle s'exécute dans GitHub Actions avec l'analyseur ruff à chaque poussée et à chaque demande de tirage.
Les tests couvrent le code qui entoure le modèle, et non le modèle. Il n'existe pas de test de bout en bout avec un modèle réel, car le pipeline dépendrait alors de la présence d'Ollama sur l'exécuteur.
Défis
Un délai d'attente signalé comme « arrêté »
Dans la bibliothèque requests, ConnectTimeout hérite à la fois de ConnectionError et de Timeout. Avec les blocs except dans le mauvais ordre, chaque délai de connexion dépassé était signalé comme « Ollama n'est pas en cours d'exécution », ce qui envoyait l'utilisateur chercher au mauvais endroit. L'ordre est corrigé et un test le fige désormais.
Une boucle de découpage qui doit se terminer
Avec le chevauchement, le segment suivant commence avant la fin du précédent, et une configuration imprudente pourrait immobiliser le curseur. Le début suivant avance toujours d'au moins un caractère, et un chevauchement aussi grand que la taille du segment est refusé d'emblée. Ces deux règles sont couvertes par des tests.
Résultats
| Mesure | Résultat | Source |
|---|---|---|
| Modes d'étude | 4 : résumé, fiches, quiz, questions-réponses | Documentation du dépôt |
| Tests automatisés | 71 fonctions de test dans 6 modules | Compté dans le dépôt |
| Intégration continue | Analyse et tests; dernière exécution réussie | GitHub Actions, vérifié le 12 octobre 2026 |
| Points d'accès réseau contactés | 1, sur localhost | Documentation du dépôt |
Tableau 1. Aucun chiffre de performance ou d'exactitude ne figure ici, car aucun n'a été mesuré.
Ce que cela ne démontre pas
- Aucune reconnaissance optique : les PDF numérisés sans texte extractible sont refusés avec un message clair.
- Les modes résumé, fiches et quiz n'utilisent que les 12 000 premiers caractères environ d'un long document, et l'interface le signale.
- La qualité des résultats dépend du modèle local que l'utilisateur a installé.
Dépôt et liens
abdeljalilsennaoui/local-ai-study-assistant(ouvre un nouvel onglet)
Ce projet n'a pas de démo hébergée. Le dépôt explique comment l'exécuter.
Fin de l'étude de cas